Usability ist ein Qualitätsmerkmal – und zwar ein besonderes
Dass Benutzbarkeit zur Softwarequalität gehört, ist in der Qualitätssicherung unstrittig. Die ISO/IEC 25010 führt sie seit jeher als eigenes Merkmal neben Zuverlässigkeit, Performance oder Sicherheit. Die zweite Ausgabe der Norm von 2023 hat diesem Merkmal sogar zusätzliches Gewicht gegeben: Usability wurde in Interaction Capability umbenannt. Mit Inclusivity sowie Self-descriptiveness sind neue Teilmerkmale hinzugekommen. Die Norm unterscheidet dabei sauber zwischen der Produktqualität – der Fähigkeit eines Systems, überhaupt bedienbar zu sein – und der Nutzungsqualität, die in der ISO/IEC 25019 beschrieben ist und danach fragt, ob Anwender*innen ihre Aufgaben tatsächlich effektiv, effizient und zufriedenstellend erledigen können. Die Bedienbarkeit ist damit Voraussetzung, nicht Ergebnis.
Für Testteams ist diese Unterscheidung mehr als Normkosmetik. Sie erklärt, warum sich Usability-Befunde nicht wie andere Befunde behandeln lassen. Ein Performance-Problem lässt sich messen und gegen eine Zielgröße prüfen. Ein Sicherheitsproblem lässt sich reproduzieren und schließen. Ein Usability-Problem zeigt sich in Verhalten – in Abbrüchen, Rückfragen, Umgehungslösungen – und die Frage, was daraus folgen soll, ist damit noch nicht beantwortet.
Eine Vorbemerkung zum Begriff: Wenn im Folgenden von GenAI die Rede ist, sind generative Verfahren als Werkzeug gemeint – Sprachmodelle und die darauf aufbauenden Anwendungen. Es geht nicht um das Testen KI-basierter Systeme, das im Testumfeld unter derselben Abkürzung mitläuft, aber eine andere Aufgabe beschreibt.
Zwei Arten von Befunden
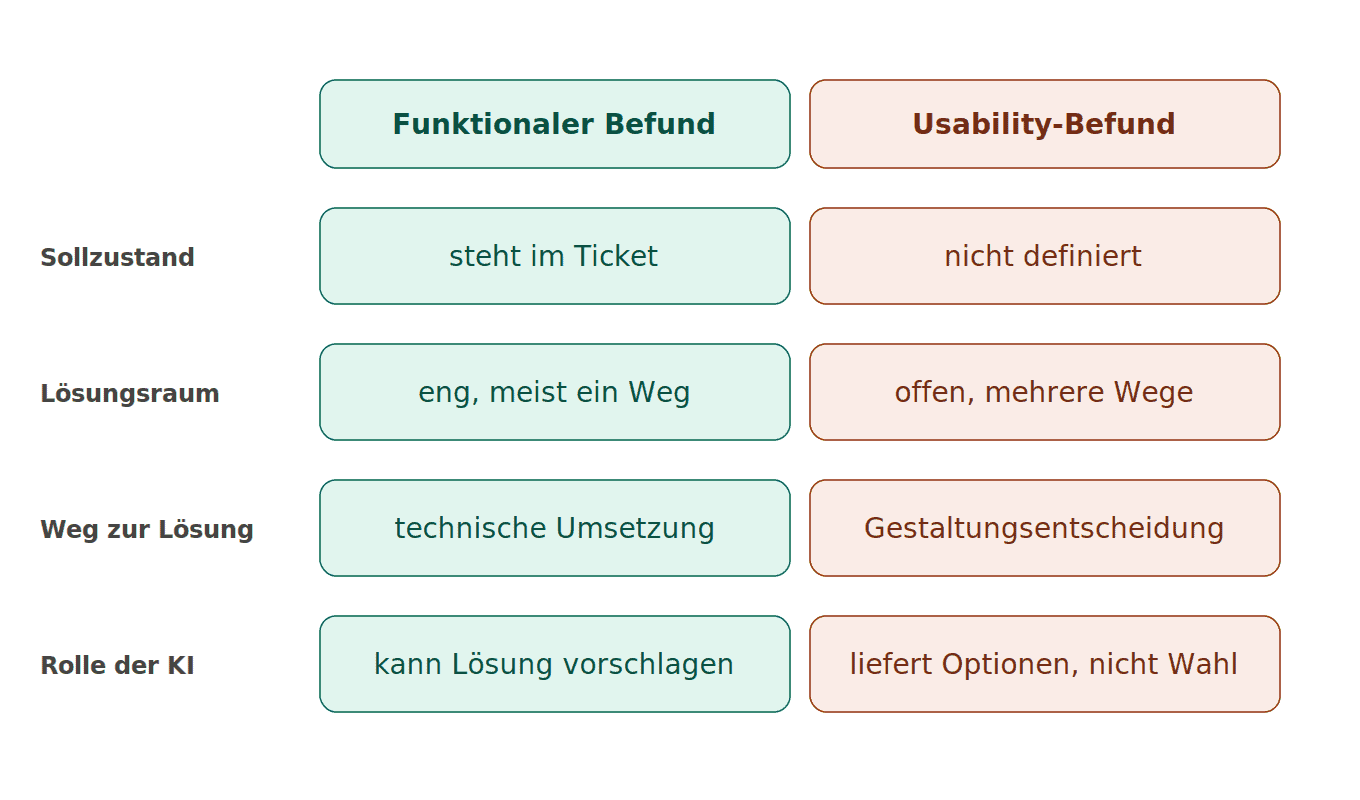
Ein funktionaler Fehler hat fast immer einen klaren Sollzustand. Das Ticket beschreibt, was falsch ist, das Akzeptanzkriterium beschreibt, was richtig wäre, und der Fix ist meist eine technische Frage: nicht was zu tun ist, sondern wie. Genau diese Eigenschaft macht funktionale Fehler gut testbar – was zunehmend auch gut durch KI unterstützt wird. Ein enger Lösungsraum lässt sich vorschlagen, weil es meist nur eine richtige Richtung gibt.
Ein Usability-Befund funktioniert anders. Er liefert Symptomatik, keinen Sollzustand: „38 % der eingereichten Anträge werden zurückgewiesen“, „Anwender verstehen den Status nicht“, „der Support erhält monatlich 140 Anfragen zu diesem Schritt“. Was daraus folgen soll, steht nirgendwo geschrieben. Die Lösung ist ein Gestaltungsakt – und dieser Akt bleibt beim Menschen, auch wenn generative KI im Testprozess mittlerweile selbstverständlich geworden ist.
Der Unterschied ist strukturell und nicht eine Frage der Sorgfalt beim Testen. Ein besser durchgeführter Usability-Test liefert präzisere Befunde, aber er liefert deshalb noch keine Lösung mit. Wer das nicht einkalkuliert, plant den aufwendigsten Teil der Arbeit nicht ein.
Warum das für Testteams wichtig ist
Ein Usability-Test, der „nur“ Probleme benennt, ohne eine Lösung mitzuliefern, wirkt für Teams, die aus dem funktionalen Testen kommen, oft unfertig. Das ist kein Mangel des Tests, sondern eine Eigenschaft des Gegenstands. Ein Assert kann prüfen, ob ein Betrag stimmt. Es kann nicht prüfen, ob eine Formulierung verständlich ist, ob eine Reihenfolge dem Denken der Anwender entspricht oder ob ein Bedienelement das auslöst, was Nutzer erwarten.
Daraus folgt eine ganz praktische Konsequenz für die Teststrategie: Usability-Tests brauchen einen nachgelagerten Schritt, der bei funktionalen Tests entfällt. Zwischen Befund und Umsetzung liegt eine Entscheidung darüber, welcher von mehreren möglichen Wegen eingeschlagen wird. Wer diesen Schritt nicht explizit im Prozess verankert, produziert Testberichte, die zwar korrekt sind, aber im Backlog liegen bleiben – weil niemand zuständig ist für die Frage, was denn nun zu tun sei.
Wo GenAI konkret helfen kann
Innerhalb dieser Grenze leistet generative KI durchaus etwas. Sie kann große Mengen an Sessionprotokollen, Freitextantworten oder Supporttickets nach wiederkehrenden Mustern durchsuchen und aus verstreuten Einzelbeobachtungen einen belastbaren Befund verdichten. Sie kann Testaufgaben und Interviewleitfäden vorbereiten, Beobachtungsnotizen strukturieren und Auswertungen so weit vorformulieren, dass ein Team schneller in die inhaltliche Diskussion kommt. Und sie kann zu einem Befund mehrere Lösungsoptionen samt grober Vor- und Nachteile skizzieren.
All das verkürzt den Weg zum Ausgangspunkt einer Entscheidung. Es ersetzt die Entscheidung nicht. Wer die Grenze verwischt, bekommt Ergebnisse, die überzeugend klingen und trotzdem falsch sind – ein Risiko, das dem Testumfeld inzwischen vertraut ist. Das ISTQB hat dafür eigene Zertifizierungen geschaffen (1). Für den Usability-Anteil dieser Arbeit gibt es eine ergänzende Perspektive (2), die dieselbe Frage von der Gestaltungsseite her stellt.
Wo GenAI an ihre Grenzen kommt
Wie unterschiedlich diese Grenzen ausfallen, zeigen zwei Befunde aus einem internen Reisekosten-Tool mit rund 2.400 Nutzenden und einer Rückweisungsquote von 38 %.
Der erste Befund ist einfach. Bei einem Validierungsfehler zeigt das System lediglich „Validierungsfehler in Feld 3“ – Systemsprache statt Nutzersprache. Anwender*innen wissen nicht, was zu tun ist, versuchen es erneut, rufen den Support an oder brechen ab. Hier ist die Lösung fast so eindeutig wie bei einem funktionalen Bug: eine konkrete Meldung, die benennt, welches Feld betroffen ist, was daran nicht stimmt und was zu tun ist. Der Gestaltungsspielraum ist klein, die Richtung liegt fest. Ein Sprachmodell kann hier sinnvoll sogar den Formulierungsvorschlag beisteuern, weil sich die Aufgabe auf eine sprachliche Umsetzung reduziert.
Der zweite Befund ist komplex. Eine Checkbox „Bewirtung“ ändert unsichtbar, welche Belege für die Abrechnung Pflicht werden. Anwender setzen sie früh im Formular, ohne zu ahnen, dass später zusätzliche Nachweise nötig sind – und werden bei der Prüfung zurückgewiesen, obwohl das Formular vollständig aussah. Der Befund ist eindeutig, die Lösung nicht. Denkbar sind mindestens drei Wege: Pflichtfelder dynamisch einblenden, sobald die Checkbox gesetzt wird; vorab eine Übersicht zeigen, welche Belege je nach Situation gebraucht werden, oder Bewirtung als eigenen Schritt in einem mehrstufigen Ablauf behandeln. Jeder dieser Wege löst das Problem, und jeder handelt sich andere Nachteile ein. Das dynamische Einblenden macht das Formular unruhig. Die vorgelagerte Übersicht kostet Zeit bei jenen Anwender*innen, die sie nicht brauchen. Der mehrstufige Ablauf ist die größte Änderung und lohnt sich nur, wenn der Fall häufig genug vorkommt.
Welcher Weg richtig ist, hängt davon ab, ob die Eingabe unterwegs am Telefon oder am Schreibtisch erfolgt, welche Vorgaben die Buchhaltung setzt und wie oft Bewirtung überhaupt abgerechnet wird. Ein Sprachmodell kennt diese Randbedingungen nicht, wenn man sie ihm nicht ausdrücklich mitgibt – und es fragt in aller Regel auch nicht danach. Es liefert stattdessen einen Vorschlag, der plausibel formuliert und genau deshalb schwer zu widerlegen ist. Das ist die eigentliche Gefahr: nicht die offensichtlich falsche Antwort, sondern die überzeugend klingende, die eine Entscheidung vorwegnimmt, die nie getroffen wurde.
Semantik statt Layout
Der zweite Fall verweist auf etwas, das in Usability-Diskussionen oft untergeht. Das Problem mit der Bewirtungs-Checkbox ist kein Layoutproblem. Es geht nicht darum, wo etwas steht oder wie es aussieht, sondern darum, was ein Bedienelement bedeutet und was es auslöst. Dieselbe Klasse von Problemen findet sich an vielen Stellen betrieblicher Software: Wirkt ein Filter sofort oder erst nach Bestätigung? Löscht „Löschen“ den Eintrag oder auch den angehängten Beleg? Zählt ein Datumsbereich vom 1. bis 31. den letzten Tag mit? – eine Frage, die bei Verpflegungspauschalen unmittelbar Geld bedeutet.
Solche Fragen sind mit funktionalen Tests nicht auffindbar, weil das System sich in jedem Fall spezifikationsgemäß verhält. Sie sind auch mit KI-generierten Entwürfen nicht zu lösen, sondern werden dort typischerweise reproduziert: Ein Modell trifft keine Bedeutungsentscheidung, wenn die Frage im Prompt nicht gestellt wurde. Es füllt die Lücke mit dem Naheliegendsten – und das Naheliegendste ist nicht dasselbe wie das Richtige.
Vom Befund zur erfolgreichen Software
Der Unterschied zwischen den beiden Beispielen ist der Kern der Sache. Manche Usability-Probleme lassen sich fast so behandeln wie ein funktionaler Bug, weil der Lösungsraum eng ist und die Richtung feststeht. Die meisten aber verlangen einen echten Gestaltungsakt, bei dem mehrere Wege offenstehen und die Wahl vom Kontext abhängt, den weder der Test noch ein Modell allein liefern kann.
Generative KI verkürzt in beiden Fällen den Weg zum Befund und zu möglichen Optionen – deutlich und messbar. Was sie nicht abnimmt, ist die Entscheidung, welcher Weg der richtige ist. Aus einem Usability-Test wird erst dann erfolgreiche Software, wenn ein Team diesen Schritt bewusst übernimmt, ihn im Prozess verankert und die dafür nötige Kontextinformation zusammenträgt. Der Test weist den Weg. Gehen muss man ihn selbst.
Anmerkungen
- (1) ISTQB Certified Tester AI Testing (CT-AI) für das Testen KI-basierter Systeme sowie Certified Tester Testing with Generative AI (CT-GenAI) für den Einsatz generativer Verfahren im Testen. Die Lehrpläne sind über die ATB-Website verfügbar
- (2) UXQCC Certified Professional in Software Usability with GenAI
Zum Autor
FH-Prof. DI Dr. techn. Robert Pucher ist Studiengangsleiter des Masterstudiengangs Software Engineering an der FH Technikum Wien und lehrt dort mit den Schwerpunkten Usability Testing und Interaction Design. Er ist Präsident der UXPA Austria und Autor des UXQCC-Syllabus zu Software-Usability mit generativer KI. Derzeit arbeitet er an einem Fachbuch zum Thema anwenderfreundliche Softwareentwicklung ohne eigene UX-Abteilung.
LinkedIn: Robert Pucher